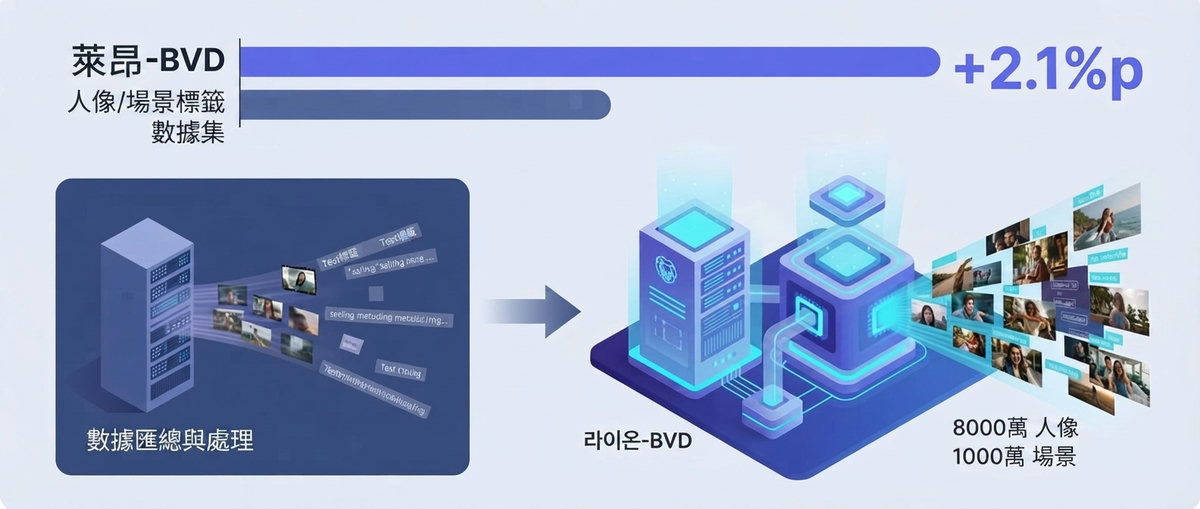
非营利人工智能研究机构LAION发布了用于人工智能多模态研究的超大型开源视频数据集——总时长达1000万小时的LAION-BVD。该数据集基于从Common Crawl收集的13亿个视频网址,通过实际下载8000万个视频构建而成。使用该数据集训练的模型在视频文本评估中,相比以往的视频基准InternVid,性能提升了最多2.1个百分点。
长期以来,大规模视频数据集及其训练的模型大多被部分垄断企业垄断,限制了独立的科学研究与复现。为了打破这种技术垄断并支持公开、可复现的多模态研究,LAION构建了该数据集。在版权问题方面,LAION根据2024年德国汉堡法院允许为非商业研究目的收集版权作品的判决,将其仅分发用于学术研究目的。
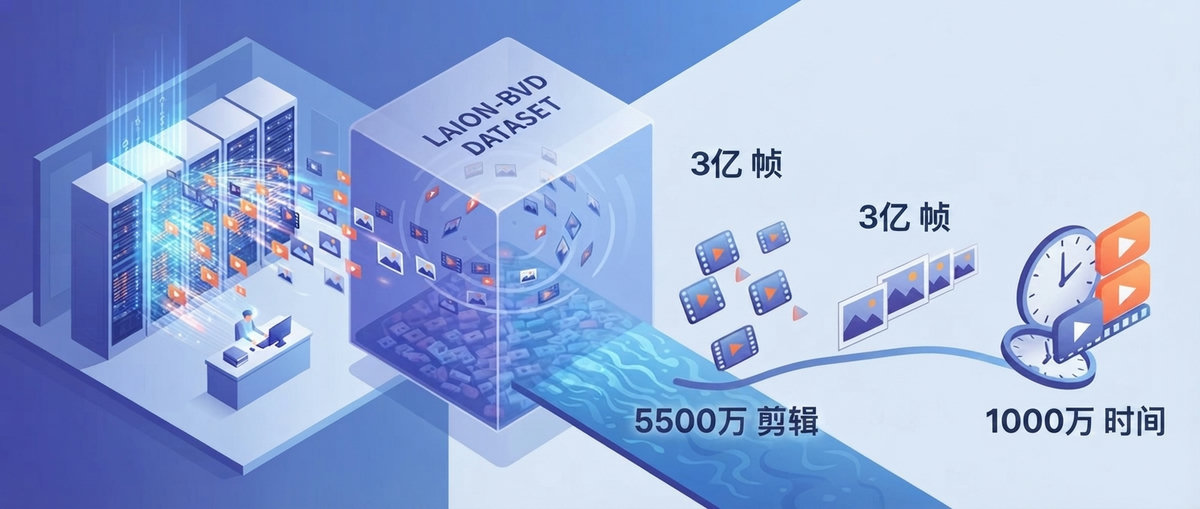
LAION-BVD包含5500万个自动生成视频和音频描述的字幕片段,以及从场景切换点提取的3亿个图像帧。每个片段的详细描述注释均利用拥有20亿参数规模的模型自动生成。相关数据集和开源代码已在Hugging Face和GitHub上免费公开,供全球研究人员立即使用。
由于LAION-BVD是用于机器学习的数据集,而非直接创作视频或音频的生成式人工智能模型,因此目前无法在5HOW.ME编辑器中运行使用。不过,该数据集为开源阵营训练涵盖视频、音频和图像领域的高级多模态人工智能模型提供了学术基础。这将直接助力独立研究人员加速开发开源视频人工智能技术,以对抗垄断企业。
参考