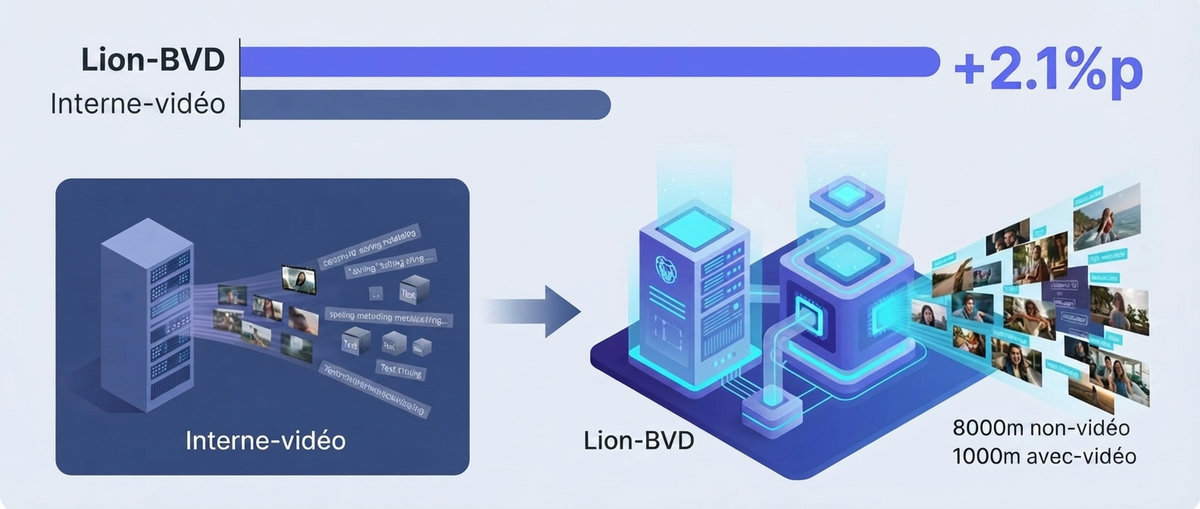
L'organisation à but non lucratif de recherche en intelligence artificielle LAION a dévoilé LAION-BVD, un ensemble de données vidéo ouvert et massif de 10 millions d'heures destiné à la recherche multimodale en IA. Cet ensemble de données a été construit en téléchargeant réellement 80 millions de vidéos sur la base de 1,3 milliard d'adresses vidéo collectées sur Common Crawl. Les modèles entraînés avec cet ensemble de données ont enregistré une performance améliorée allant jusqu'à 2,1 points de pourcentage dans l'évaluation texte-vidéo par rapport à InternVid, un benchmark vidéo existant.
Jusqu'à présent, les ensembles de données vidéo à grande échelle et les modèles entraînés à l'aide de ceux-ci étaient pour la plupart l'apanage de quelques entreprises monopolistiques, ce qui limitait la recherche scientifique indépendante et la reproductibilité. LAION a construit cet ensemble de données pour briser ce monopole technologique et soutenir une recherche multimodale ouverte et reproductible. Concernant les questions de droits d'auteur, LAION le distribue uniquement à des fins de recherche académique, en s'appuyant sur un jugement du tribunal de Hambourg en Allemagne rendu en 2024, qui autorise la collecte d'œuvres protégées à des fins de recherche non commerciale.
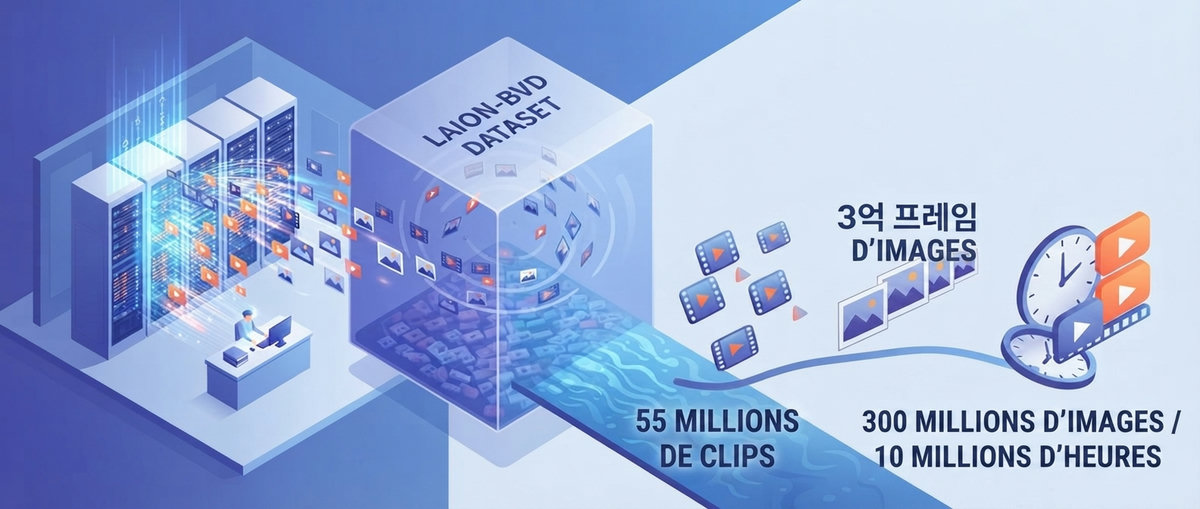
LAION-BVD comprend 55 millions de clips de sous-titres avec des descriptions vidéo et audio générées automatiquement, ainsi que 300 millions d'images fixes extraites aux points de changement de scène. Les annotations de description détaillée de chaque clip ont été générées automatiquement à l'aide d'un modèle doté de 2 milliards de paramètres. L'ensemble de données et le code open source associé sont mis à disposition gratuitement sur Hugging Face et GitHub, permettant aux chercheurs du monde entier de les utiliser immédiatement.
Étant donné que LAION-BVD est un ensemble de données pour l'apprentissage automatique et non un modèle d'intelligence artificielle générative qui produit directement des vidéos ou de l'audio, il ne peut pas être exécuté et utilisé actuellement dans l'éditeur 5HOW.ME. Cependant, cet ensemble de données fournit une base académique permettant au camp open source d'entraîner des modèles d'intelligence artificielle multimodaux avancés englobant les domaines de la vidéo, de l'audio et de l'image. Cela contribue directement à accélérer le développement de technologies d'IA vidéo open source par des chercheurs indépendants, en réponse aux entreprises monopolistiques.
참고