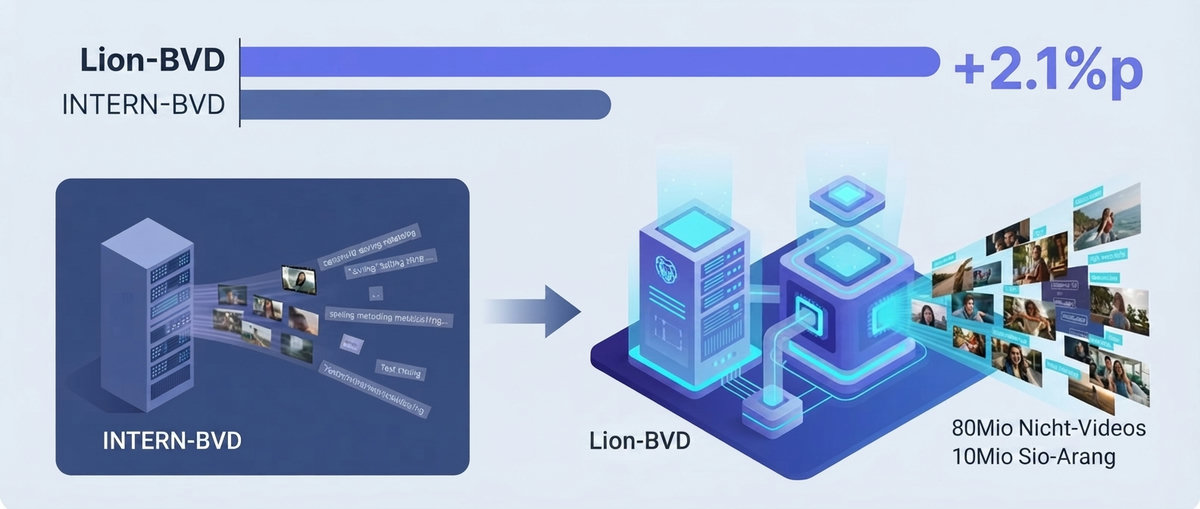
Die gemeinnützige KI-Forschungsorganisation LAION hat LAION-BVD vorgestellt, einen riesigen offenen Videodatensatz mit einer Länge von 10 Millionen Stunden für die multimodale KI-Forschung. Dieser Datensatz wurde erstellt, indem 80 Millionen Videos basierend auf 1,3 Milliarden Video-URLs, die aus Common Crawl gesammelt wurden, tatsächlich heruntergeladen wurden. Modelle, die mit diesem Datensatz trainiert wurden, zeigten im Vergleich zum bestehenden Video-Benchmark InternVid eine um bis zu 2,1 Prozentpunkte verbesserte Leistung bei der Video-Text-Evaluierung.
Bisher waren groß angelegte Videodatensätze und die darauf trainierten Modelle größtenteils das Privileg weniger proprietärer Unternehmen, was die unabhängige wissenschaftliche Forschung und Reproduzierbarkeit einschränkte. LAION hat diesen Datensatz erstellt, um dieses Technologiemonopol zu brechen und eine offene sowie reproduzierbare multimodale Forschung zu unterstützen. Bezüglich urheberrechtlicher Fragen stützt sich LAION auf ein Urteil des Landgerichts Hamburg aus dem Jahr 2024, das die Sammlung von Werken für nichtkommerzielle Forschungszwecke erlaubt, und vertreibt ihn ausschließlich für akademische Forschungszwecke.
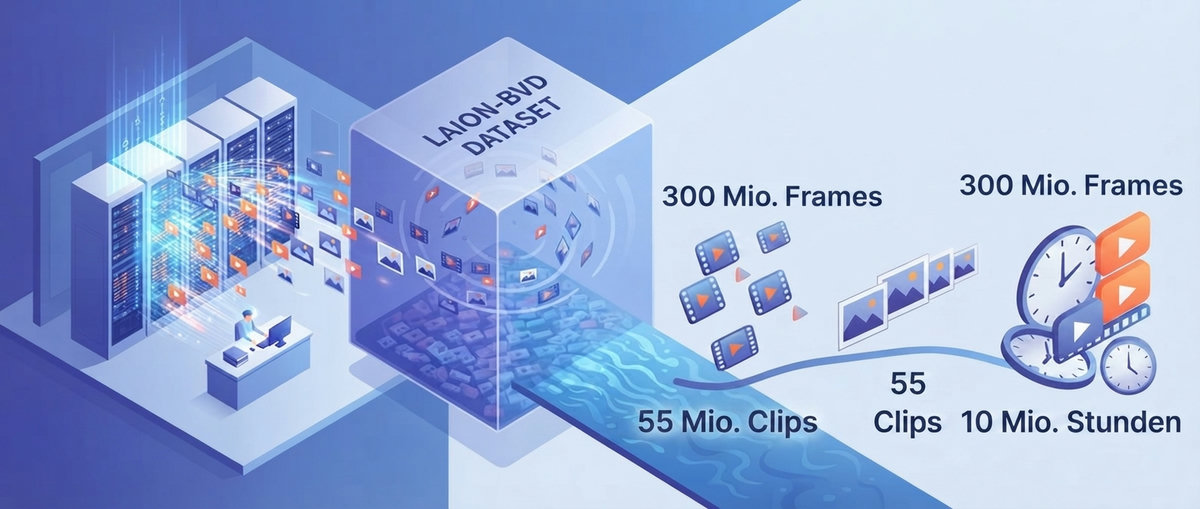
LAION-BVD enthält 55 Millionen Caption-Clips mit automatisch generierten Video- und Audio-Beschreibungen sowie 300 Millionen Bildframes, die an Szenenwechseln extrahiert wurden. Die detaillierten Beschreibungsannotationen für jeden Clip wurden automatisch mithilfe eines Modells mit 2 Milliarden Parametern generiert. Der entsprechende Datensatz und der dazugehörige Open-Source-Code sind auf Hugging Face und GitHub frei verfügbar, sodass Forscher weltweit sie sofort nutzen können.
Da es sich bei LAION-BVD um einen Datensatz für maschinelles Lernen und nicht um ein generatives KI-Modell zur direkten Erstellung von Videos oder Audio handelt, kann er derzeit nicht im 5HOW.ME Editor ausgeführt werden. Dieser Datensatz bietet jedoch eine akademische Grundlage für das Open-Source-Lager, um hochentwickelte multimodale KI-Modelle zu trainieren, die die Bereiche Video, Audio und Bild umfassen. Dies trägt direkt dazu bei, die Entwicklung von Open-Source-Video-KI-Technologien durch unabhängige Forscher als Gegenreaktion zu proprietären Unternehmen zu beschleunigen.
참고