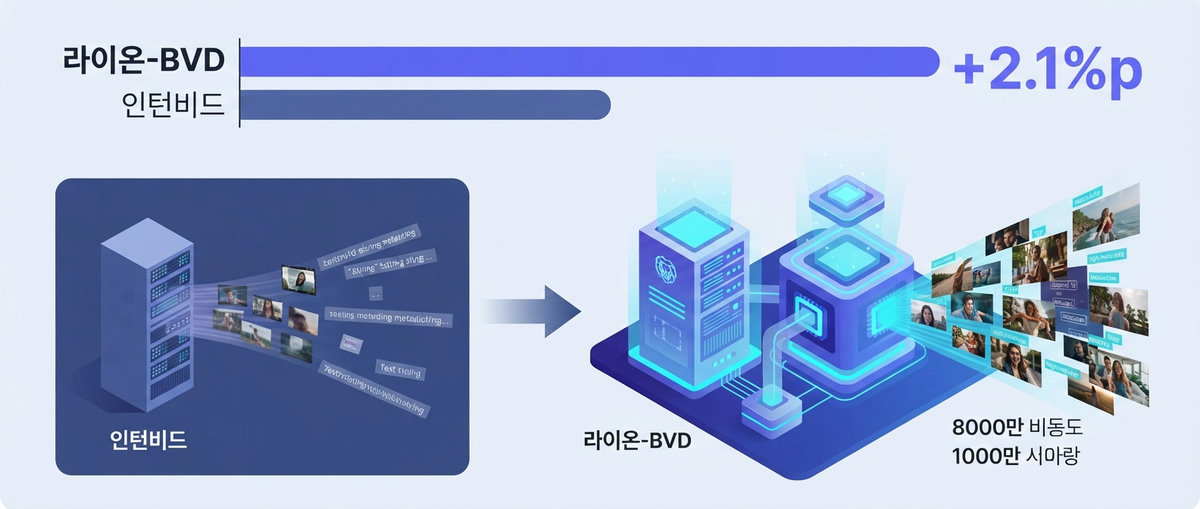
비영리 인공지능 연구 단체 라이온이 인공지능 멀티모달 연구를 위한 1000만 시간 분량의 초대형 오픈 비디오 데이터셋인 라이온-BVD를 공개했습니다. 이 데이터셋은 커먼 크롤에서 수집한 13억 개의 비디오 주소를 기반으로 8000만 개의 영상을 실제 다운로드하여 구축되었습니다. 해당 데이터셋으로 훈련된 모델은 기존의 비디오 벤치마크인 인턴비드 대비 비디오 텍스트 평가에서 최대 2.1퍼센트포인트 향상된 성능을 기록했습니다.
그동안 대규모 비디오 데이터셋과 이를 활용해 훈련된 모델들은 대부분 일부 독점적인 기업들의 전유물이었기에 독립적인 과학적 연구와 재현이 제한적이었습니다. 라이온은 이러한 기술 독점을 해소하고 공개적이고 재현 가능한 멀티모달 연구를 지원하기 위해 이번 데이터셋을 구축했습니다. 저작권 문제와 관련하여 라이온은 비상업적 연구 목적으로 저작물을 수집할 수 있도록 인정한 2024년 독일 함부르크 법원 판결을 바탕으로 학술 연구 목적으로만 이를 배포합니다.
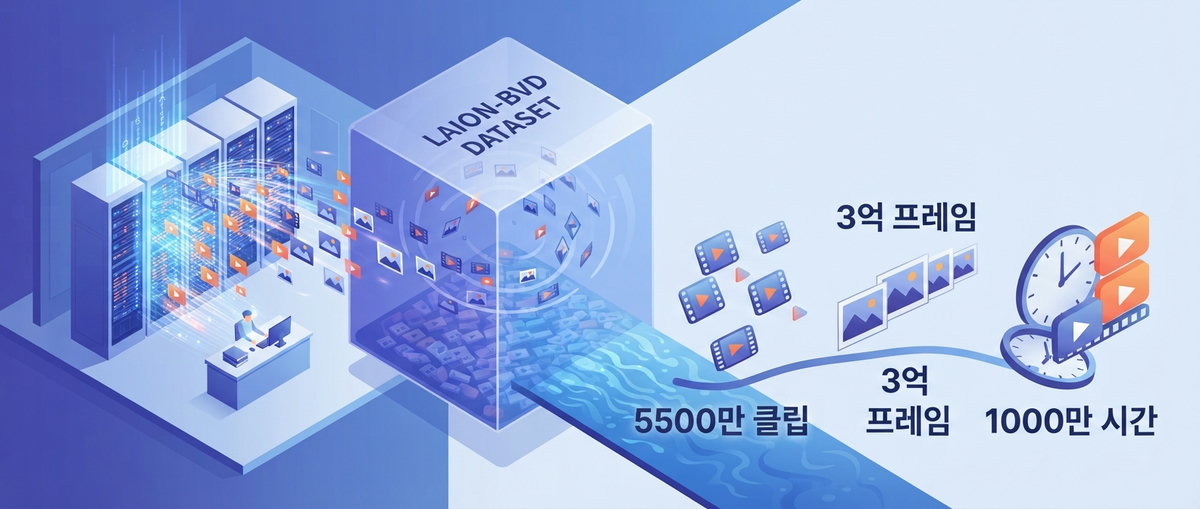
라이온-BVD는 비디오와 오디오 묘사가 자동 생성된 5500만 개의 캡션 클립과 장면 변화 시점에서 추출한 3억 개의 이미지 프레임을 포함합니다. 각 클립의 상세한 묘사 주석은 20억 매개변수 규모의 모델을 활용해 자동으로 생성되었습니다. 해당 데이터셋과 관련 오픈소스 코드는 허깅페이스와 깃허브에서 무료로 공개되어 전 세계 연구자들이 즉시 활용할 수 있습니다.
라이온-BVD는 비디오나 오디오를 직접 제작하는 생성형 인공지능 모델이 아닌 기계 학습용 데이터셋이므로 현재 5HOW.ME 에디터에서 구동하여 사용할 수는 없습니다. 하지만 이 데이터셋은 오픈소스 진영에서 비디오와 오디오 및 이미지 영역을 아우르는 고도화된 멀티모달 인공지능 모델을 훈련할 수 있는 학술적 토대를 제공합니다. 이는 독점 기업에 대응해 독립 연구자들의 오픈소스 비디오 인공지능 기술 개발을 가속하는 데 직접적으로 기여합니다.
참고