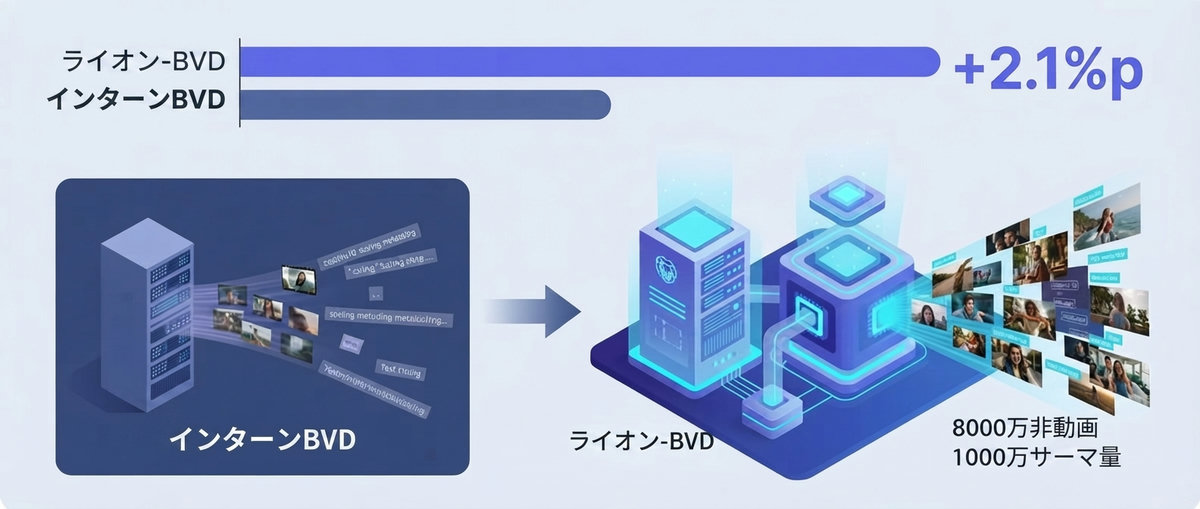
非営利の人工知能研究団体LAIONが、AIのマルチモーダル研究に向けた1000万時間分の超大型オープンビデオデータセット「LAION-BVD」を公開しました。このデータセットは、Common Crawlから収集した13億個のビデオアドレスを基に、8000万本の映像を実際にダウンロードして構築されました。該当データセットでトレーニングされたモデルは、従来のビデオベンチマークであるInternVidと比較して、ビデオテキスト評価で最大2.1パーセントポイント向上したパフォーマンスを記録しました。
これまで、大規模なビデオデータセットとそれらを活用してトレーニングされたモデルは、その大部分が一部の独占企業の専有物であったため、独立した科学的研究や再現が制限されていました。LAIONはこうした技術の独占を解消し、オープンかつ再現可能なマルチモーダル研究を支援するために今回のデータセットを構築しました。著作権の問題に関して、LAIONは非商業的研究目的での著作物の収集を認めた2024年のドイツ・ハンブルク裁判所の判決に基づき、学術研究目的に限定してこれを配布します。
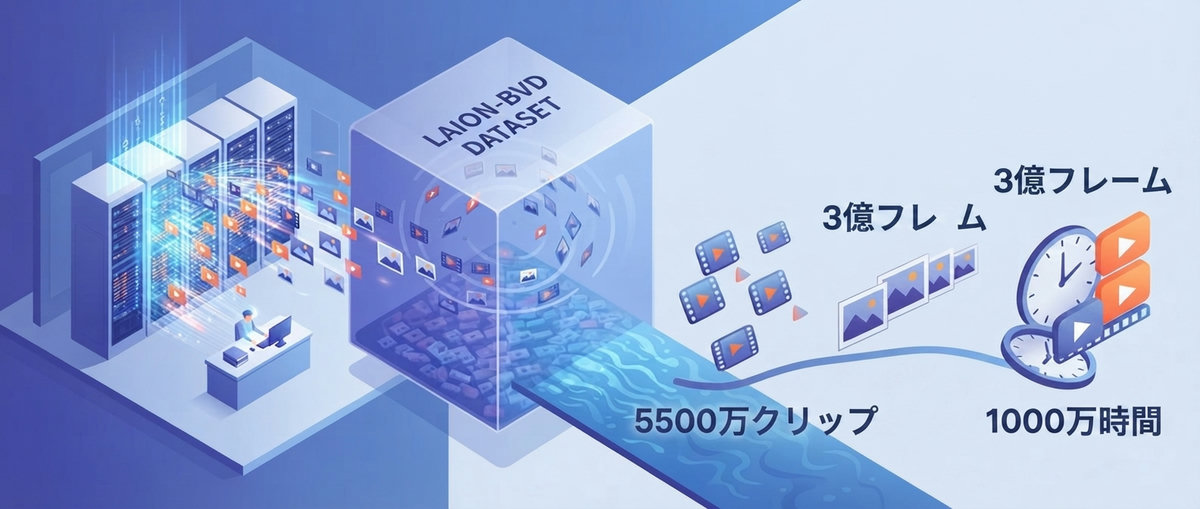
LAION-BVDには、ビデオとオーディオの説明が自動生成された5500万件のキャプションクリップと、シーンチェンジの時点で抽出された3億枚の画像フレームが含まれています。各クリップの詳細な説明アノテーションは、20億パラメータ規模のモデルを活用して自動生成されました。該当データセットと関連するオープンソースコードは、Hugging FaceとGitHubで無料公開され、世界中の研究者が直ちに利用できるようになっています。
LAION-BVDは、ビデオやオーディオを直接制作する生成AIモデルではなく機械学習用のデータセットであるため、現在5HOW.MEエディターで稼働させて使用することはできません。しかし、このデータセットはオープンソース陣営において、ビデオ、オーディオ、画像の領域を網羅する高度なマルチモーダルAIモデルをトレーニングするための学術的基盤を提供します。これは、独占企業に対抗して独立研究者によるオープンソースのビデオAI技術の開発を加速させることに直接貢献します。
参考